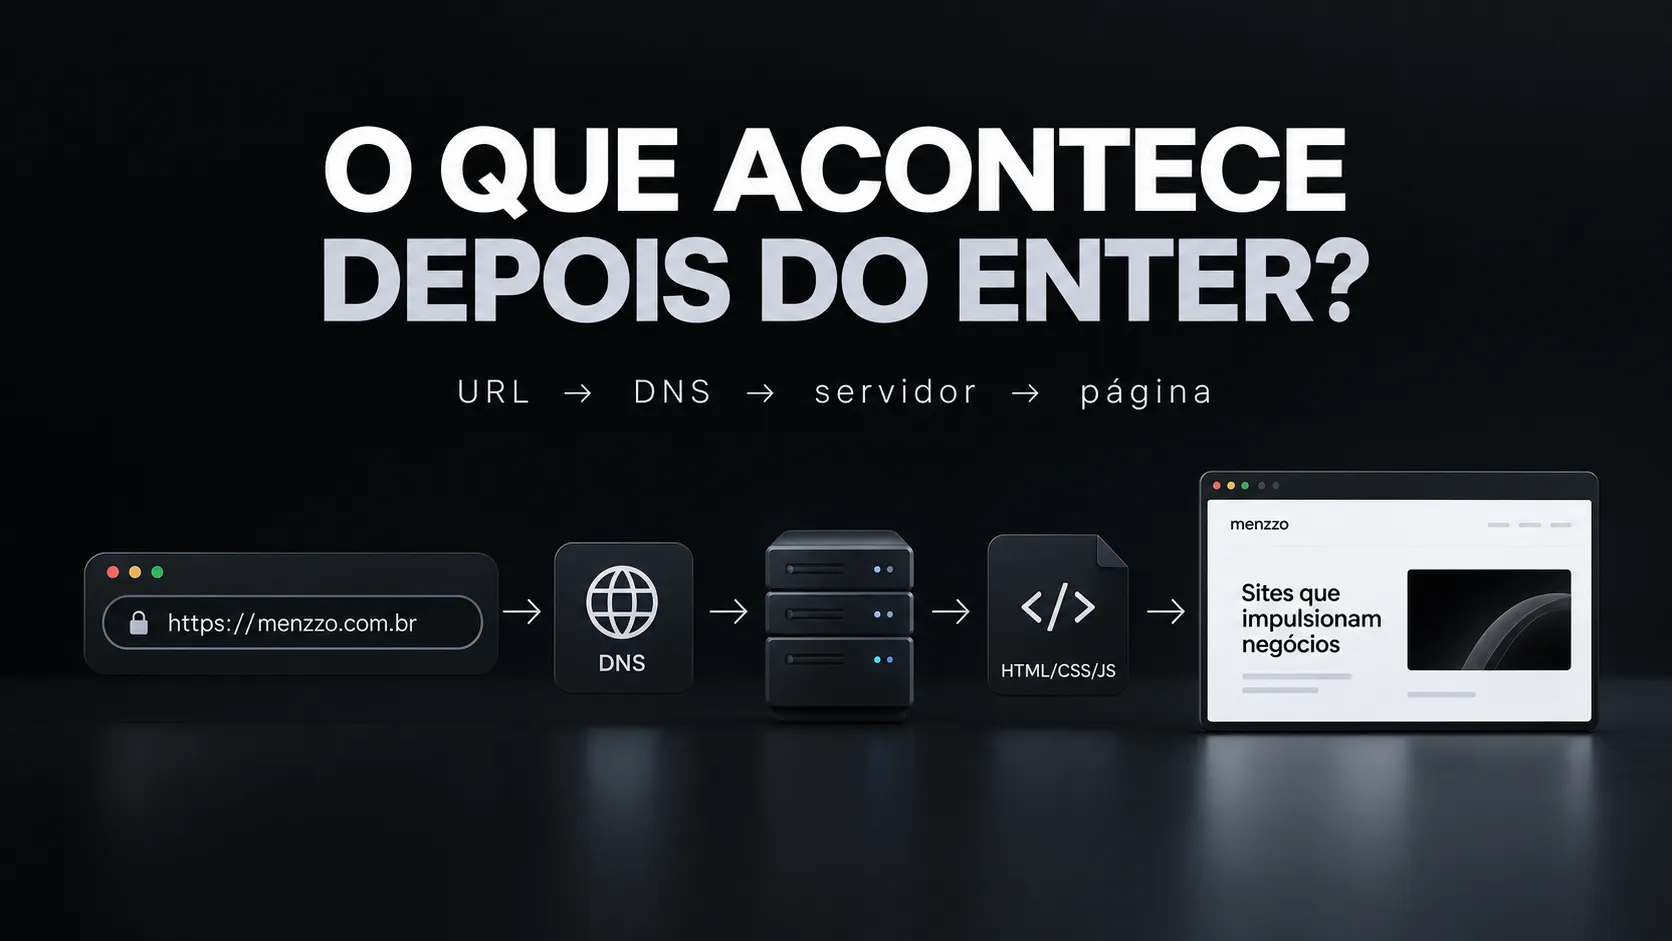
O que acontece depois que você digita um endereço no navegador?
Você abre o Chrome, Firefox, Safari ou Edge.
Digita:
https://www.exemplo.com
Pressiona Enter.
Pouco depois, textos aparecem, imagens carregam, fontes mudam, botões começam a funcionar e uma página inteira surge na tela.
Parece uma única ação.
Na realidade, seu navegador acabou de participar de uma sequência envolvendo URL, cache, DNS, endereços IP, criptografia, protocolos de rede, servidores, bancos de dados, HTML, CSS, JavaScript e a GPU do seu dispositivo.
Tudo isso pode acontecer em uma fração de segundo.
Em uma visão simplificada, o caminho é:
Mas essa sequência esconde vários detalhes interessantes.
Vamos acompanhar a viagem completa.
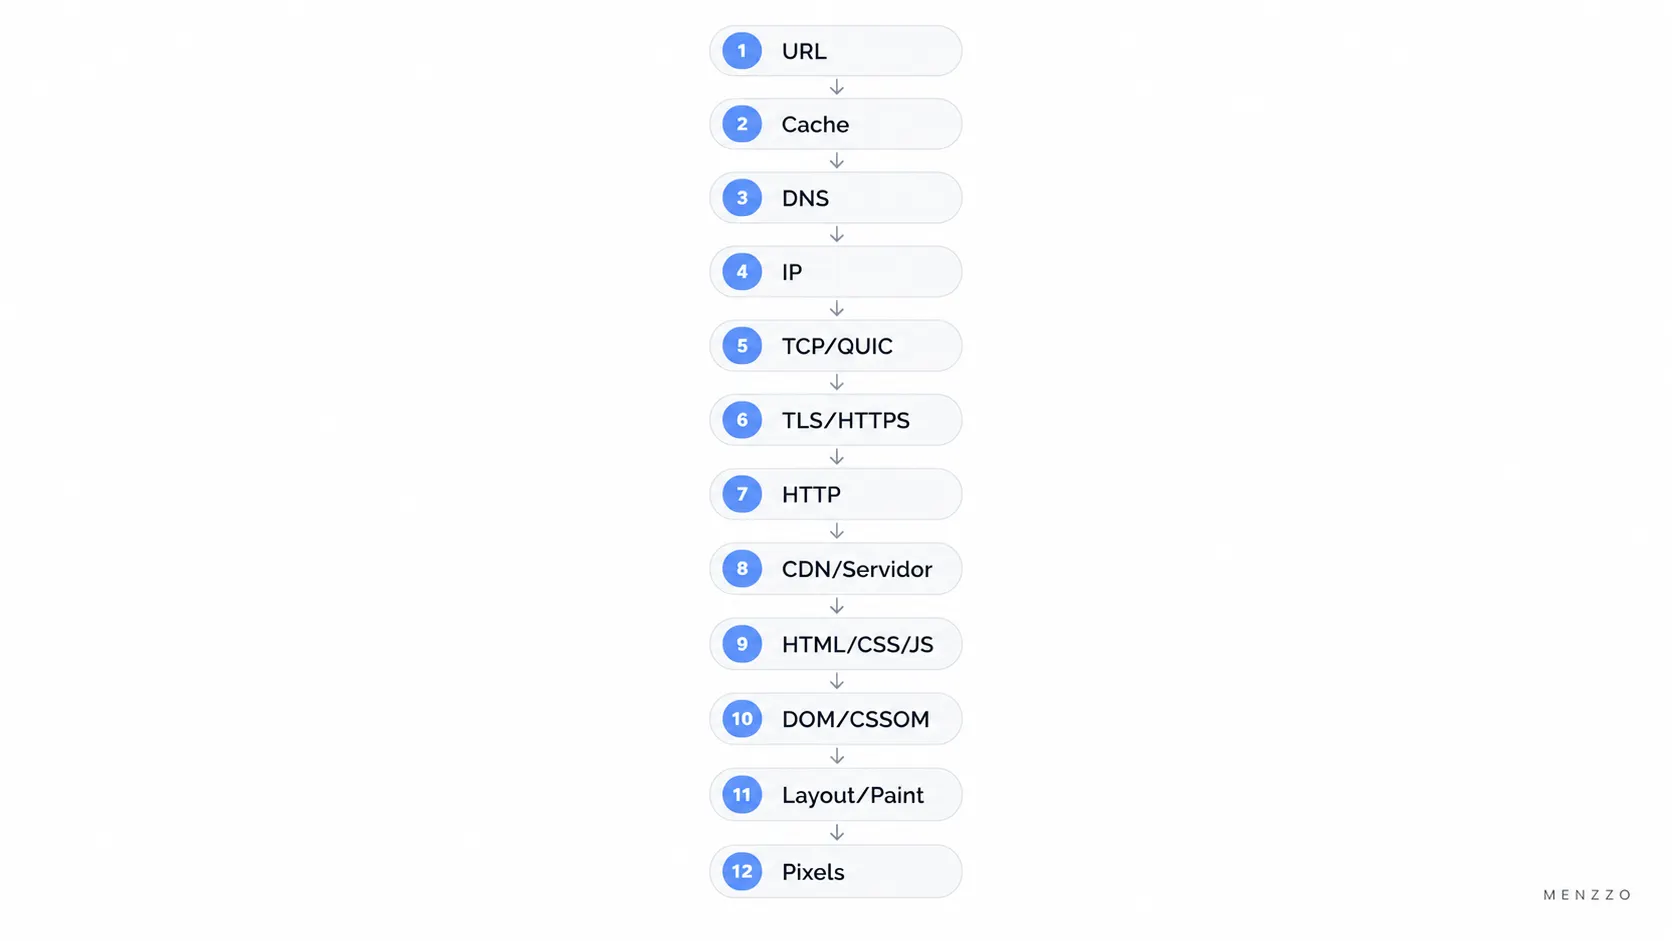
Resposta rápida: o que acontece quando você digita uma URL no navegador?
Quando você digita um endereço e pressiona Enter, o navegador primeiro interpreta a URL e identifica o domínio solicitado.
Se ainda não possuir as informações necessárias em cache, utiliza o DNS para descobrir qual endereço IP está associado ao domínio.
Em seguida, estabelece uma conexão com o destino. Em HTTPS, também existe uma negociação criptográfica. No HTTP/1.1 e HTTP/2 isso normalmente envolve TCP e TLS; no HTTP/3, o navegador utiliza QUIC sobre UDP.
Depois, o navegador envia uma requisição HTTP.
O servidor ou uma infraestrutura intermediária processa essa requisição e devolve uma resposta.
Quando recebe o HTML, o navegador começa a interpretá-lo, descobre CSS, JavaScript, imagens, fontes e outros recursos, realiza novas requisições e constrói estruturas internas como DOM e CSSOM.
Finalmente, calcula estilos, posições e dimensões, pinta os elementos e compõe as diferentes camadas até transformar código em pixels na sua tela.
Essa é a resposta curta.
Agora vamos abrir cada parte.
1. Tudo começa na barra de endereço
Suponha que você digite:
Esse endereço contém várias informações.
Parte | Exemplo | Função |
|---|---|---|
Esquema |
| Define como acessar o recurso |
Host |
| Identifica o host/domínio |
Caminho |
| Identifica o recurso |
Query string |
| Envia parâmetros |
Fragmento |
| Aponta para uma parte do documento |
Chamamos o endereço completo de URL — Uniform Resource Locator.
É importante distinguir URL de domínio.
exemplo.com é um domínio.
https://exemplo.com/produtos?id=10 é uma URL.
Um domínio é apenas uma das partes que podem existir dentro de uma URL.
E se eu digitar apenas “menzzo” na barra?
Browsers modernos possuem uma omnibox: a mesma caixa pode funcionar como barra de endereços e busca.
Por isso, antes de começar toda aquela viagem, o navegador precisa interpretar sua entrada.
Se você digitar:
é claramente uma URL.
Se digitar:
provavelmente será considerada uma pesquisa.
O navegador enviará a consulta para o mecanismo de busca configurado.
Ou seja, nem tudo digitado na barra de endereços inicia imediatamente uma navegação para um domínio específico.
2. Antes de sair pela internet, o navegador tenta economizar trabalho
Um detalhe frequentemente ignorado:
o navegador não quer repetir trabalho desnecessariamente.
Se você já visitou aquele endereço, várias informações podem estar disponíveis localmente.
Dependendo da situação, ele pode reaproveitar:
respostas HTTP em cache;
registros DNS;
conexões abertas;
certificados e sessões criptográficas;
arquivos estáticos;
conteúdo gerenciado por service workers.
O cache HTTP existe justamente para permitir que respostas previamente obtidas sejam reutilizadas sem precisar buscar novamente todos os dados no servidor de origem. Isso pode reduzir latência, transferência de dados e processamento no servidor.
É por isso que esta sequência:
não acontece necessariamente do zero em toda visita.
Essa é uma das simplificações mais comuns em explicações sobre o funcionamento da Web.
3. O navegador precisa descobrir onde o site está
Humanos gostam de nomes como:
Redes trabalham com endereços IP.
É aí que entra o DNS — Domain Name System.
Sua função principal é transformar um nome fácil para humanos em um endereço utilizável pela rede.
Exemplo simplificado:
O DNS funciona como um sistema distribuído de resolução de nomes. A Cloudflare o compara a uma espécie de lista telefônica da internet: o domínio é o nome; o IP é o endereço necessário para chegar ao destino.
4. O navegador procura o DNS em cache primeiro
Fazer uma consulta DNS completa toda vez seria desperdício.
Por isso, informações podem existir em caches em diferentes pontos.
De forma simplificada:
Se um resultado válido já estiver armazenado, várias etapas podem desaparecer.
O cache é um dos motivos pelos quais acessar novamente um domínio pode ser mais rápido do que acessá-lo pela primeira vez.
5. O que acontece quando o DNS não está em cache?
Aí aparece uma das partes mais interessantes.
Seu dispositivo normalmente consulta um resolvedor DNS recursivo.
Esse resolvedor pode pertencer:
ao seu provedor;
à empresa;
a um serviço público;
ou a outro provedor configurado no sistema ou navegador.
Se ele também não conhecer a resposta, inicia o processo para descobri-la.
Simplificando:
Vamos entender.
Servidor raiz
Ele não precisa conhecer diretamente o IP de todos os sites do planeta.
Ele sabe indicar onde procurar a extensão adequada.
Se buscamos:
ele ajuda a encontrar os servidores responsáveis pelo .com.
Servidor TLD
TLD significa Top-Level Domain.
Exemplos:
.com
.org
.net
.br
O servidor correspondente consegue indicar quem possui autoridade sobre o domínio procurado.
Servidor DNS autoritativo
É onde ficam os registros DNS relevantes daquele domínio.
Ele pode finalmente responder algo como:
O resolvedor devolve essa informação para seu dispositivo e pode armazená-la em cache por determinado período.
6. O resultado pode ser IPv4 ou IPv6
Existem diferentes tipos de registros DNS.
Dois especialmente importantes são:
A
aponta para um endereço IPv4.
AAAA
aponta para um endereço IPv6.
Um registro A poderia representar algo parecido com:
Enquanto IPv6 utiliza endereços muito maiores.
Um domínio pode oferecer os dois.
O navegador e o sistema podem avaliar qual caminho funciona melhor para aquela conexão.
7. DNS moderno também pode ser criptografado
Historicamente, consultas DNS comuns podiam viajar sem criptografia.
Hoje existem tecnologias como:
DNS over HTTPS — DoH
e
DNS over TLS — DoT.
Elas criptografam a comunicação entre o cliente e o resolvedor DNS, dificultando que terceiros na rede simplesmente observem ou modifiquem aquelas consultas.
Isso não muda o objetivo principal do DNS.
Continua sendo:
Muda a maneira como parte dessa comunicação pode ser protegida.
8. Encontrar o IP não significa necessariamente encontrar o servidor de origem
Aqui aparece outra simplificação comum.
Imagine que o site esteja hospedado em um servidor em outro continente.
Seu navegador precisa sempre conversar diretamente com ele?
Não.
Muitos sites utilizam uma CDN — Content Delivery Network.
Nesse caso, o endereço retornado pode levar você a uma infraestrutura distribuída capaz de responder a partir de um ponto muito mais próximo.
Em vez de:
podemos ter:
CDNs podem armazenar recursos em cache e reduzir distância, latência e carga sobre a origem. A AWS destaca justamente que uma CDN pode entregar conteúdo por uma infraestrutura distribuída mais próxima do navegador.
9. Agora o navegador precisa estabelecer uma conexão
Sabemos onde queremos chegar.
Precisamos conseguir conversar.
E aqui a história depende do protocolo utilizado.
HTTP/1.1 e HTTP/2
Em HTTPS, normalmente teremos:
HTTP/3
Temos uma arquitetura diferente:
HTTP/3 utiliza QUIC em vez de TCP. O QUIC incorpora a negociação criptográfica à criação da conexão e foi desenvolvido, entre outras coisas, para diminuir latência e reduzir problemas causados por perda de pacotes entre diferentes streams.
Portanto, a frase:
“o navegador sempre abre uma conexão TCP antes de carregar um site”
já não é tecnicamente correta para toda a Web moderna.
10. Como funciona uma conexão TCP?
Quando TCP é utilizado, cliente e servidor precisam inicialmente se reconhecer.
Existe o famoso three-way handshake:
Depois disso, existe uma conexão TCP pronta para transportar dados.
O protocolo também fornece mecanismos de confiabilidade, controle e reenvio quando pacotes não chegam corretamente.
É um dos pilares históricos da Web.
Mas estabelecer conexões exige viagens entre cliente e servidor.
E distância custa tempo.
11. Por que HTTP/2 melhorou o carregamento?
Em HTTP/1.1, administrar muitos recursos podia exigir múltiplas conexões e causar várias limitações.
HTTP/2 introduziu multiplexação.
Isso permite que diversas mensagens HTTP trafeguem de forma mais eficiente através da mesma conexão.
Mas havia um problema mais abaixo.
HTTP/2 ainda estava sobre TCP.
Se um pacote TCP fosse perdido, diferentes streams poderiam acabar esperando pela recuperação daquele pacote.
HTTP/3 tenta melhorar esse cenário utilizando QUIC, onde streams possuem tratamento independente para determinados tipos de perda.
12. Se o site usa HTTPS, entra o TLS
Hoje você provavelmente acessa:
e não simplesmente:
O S significa que HTTP está sendo utilizado com proteção criptográfica.
No caso tradicional de HTTPS sobre TCP, depois da conexão TCP temos a negociação TLS — Transport Layer Security.
O objetivo é permitir que cliente e servidor estabeleçam uma comunicação criptografada e verifiquem a identidade apresentada pelo servidor.
Em uma visão simplificada:
Isso impede que o conteúdo da comunicação possa simplesmente ser lido como texto aberto por alguém observando a rede.
13. O que o certificado HTTPS realmente comprova?
Um certificado digital ajuda o navegador a verificar que está conversando com uma entidade autorizada para aquele domínio.
O navegador analisa informações como:
domínio;
validade;
assinatura;
cadeia de confiança.
Se algo estiver errado, você pode receber um alerta de segurança.
É por isso que erros de certificado conseguem impedir a navegação mesmo quando o servidor tecnicamente está respondendo.
14. E se eu digitar o endereço sem HTTPS?
Você pode digitar apenas:
Browsers modernos podem tentar HTTPS diretamente em diferentes circunstâncias.
Além disso, existe o HSTS — HTTP Strict Transport Security.
Quando um site utiliza HSTS e o navegador já conhece essa política — ou possui aquela informação pré-carregada — tentativas de acesso por HTTP podem ser automaticamente convertidas para HTTPS antes de uma navegação insegura.
Portanto, não pense necessariamente em:
como algo obrigatório em toda visita.
15. Agora finalmente podemos enviar a requisição HTTP
Depois de encontrar o destino e estabelecer a comunicação necessária, o navegador pode pedir o recurso.
Uma representação didática de uma requisição seria:
Em protocolos modernos, a representação interna não é necessariamente exatamente essa forma textual, mas a semântica continua familiar.
O navegador informa coisas como:
o método;
o recurso;
headers;
formatos aceitos;
cookies quando aplicáveis;
informações de cache.
Uma requisição HTTP não significa simplesmente:
“mande o site”.
Ela contém um conjunto de informações que servidor e infraestrutura usam para decidir o que devolver.
16. O que significa GET?
GET é um método HTTP.
É normalmente utilizado para obter um recurso.
Por exemplo:
Mas HTTP possui vários outros métodos:
POST
PUT
PATCH
DELETE
HEAD
e outros.
É a mesma base que aparece quando trabalhamos com APIs.
Se quiser aprofundar essa parte, temos um guia completo sobre como funciona uma API e por que praticamente todo sistema moderno usa uma.
17. A requisição pode passar por várias máquinas antes da aplicação
Outro ponto importante:
é apenas uma representação simplificada.
Na prática, você pode encontrar:
Nem todo site utiliza tudo isso.
Mas aplicações grandes frequentemente possuem diversas camadas.
CDN
Pode responder com conteúdo já armazenado.
WAF
Pode analisar a requisição em busca de ataques.
Load balancer
Distribui tráfego entre diferentes servidores.
Reverse proxy
Pode encaminhar requisições para serviços adequados.
Só depois disso uma aplicação pode começar a executar sua lógica.
18. O que o servidor faz quando recebe a requisição?
Depende completamente do site.
Um site estático pode simplesmente encontrar um arquivo e devolvê-lo.
Uma aplicação dinâmica talvez precise executar código:
Talvez ela precise:
identificar o usuário;
consultar sessão;
verificar permissões;
buscar produto;
consultar estoque;
calcular preço;
ler banco;
chamar APIs externas;
montar HTML.
É por isso que duas páginas aparentemente iguais podem possuir arquiteturas completamente diferentes.
Temos outro guia que aprofunda justamente a diferença entre site estático, site dinâmico e sistema web.
19. A página pode nem ser gerada pelo servidor
Outra possibilidade é o servidor entregar um HTML relativamente pequeno contendo JavaScript.
Então parte importante da interface é criada posteriormente no navegador.
Esse modelo aparece bastante em aplicações construídas com frameworks JavaScript.
Também existem abordagens híbridas:
SSR;
SSG;
CSR;
streaming;
hydration.
Portanto, dizer:
“o servidor envia a página pronta”
nem sempre representa a arquitetura real.
Ele pode enviar:
HTML completamente pronto;
HTML parcialmente pronto;
dados;
JavaScript;
ou uma combinação de tudo isso.
20. O servidor devolve uma resposta HTTP
Depois de processar a requisição, surge uma resposta.
Algo parecido com:
e depois:
A resposta possui:
status
headers
body, quando aplicável.
Os headers explicam como o cliente deve interpretar e tratar aquela resposta.
O body contém o recurso propriamente dito.
21. O que significa 200, 301, 404 e 500?
Você provavelmente já viu esses números.
Eles são status codes HTTP.
Faixa | Significado |
|---|---|
1xx | Informação |
2xx | Sucesso |
3xx | Redirecionamento |
4xx | Problema relacionado à solicitação/cliente |
5xx | Problema no servidor |
Alguns exemplos:
200 OK
A requisição foi atendida com sucesso.
301 Moved Permanently
O recurso mudou permanentemente de endereço.
302 Found
Redirecionamento temporário em cenários apropriados.
404 Not Found
O recurso não foi encontrado.
500 Internal Server Error
O servidor encontrou um erro ao processar a solicitação.
Essas classes são definidas pela semântica do HTTP.
22. Um redirecionamento pode fazer parte da viagem
Imagine acessar:
O servidor responde:
O navegador então precisa acessar a nova URL.
Ou seja:
Redirecionamentos são normalmente transparentes para o usuário, mas adicionam trabalho e podem aumentar o tempo necessário para chegar ao conteúdo final.
No SEO, isso também importa bastante.
Redirecionamentos bem implementados são fundamentais durante migrações e mudanças de URL.
23. Talvez o servidor nem precise enviar novamente o recurso
Imagine que seu navegador já possua uma imagem armazenada.
Ele pode reutilizá-la diretamente conforme as regras de cache.
Ou pode perguntar ao servidor se sua cópia continua válida.
Se o servidor responder:
está basicamente dizendo:
“o recurso não mudou; continue usando sua versão armazenada.”
Isso evita retransmitir o conteúdo completo.
É uma enorme otimização.
24. A resposta também pode chegar comprimida
HTML, CSS e JavaScript são texto.
Texto geralmente comprime muito bem.
Por isso, servidor e cliente podem negociar formatos de compressão.
Dois muito conhecidos são:
gzip
e
Brotli (br).
Um header pode indicar:
O browser recebe o conteúdo comprimido, descomprime e então continua o processamento. A compressão HTTP reduz a quantidade de dados que precisa atravessar a rede.
25. O navegador não espera o HTML inteiro chegar para começar
Essa parte é fascinante.
O navegador consegue começar a trabalhar enquanto o documento ainda está sendo recebido.
Os primeiros bytes chegam.
Ele começa a interpretar.
Mais dados chegam.
Ele continua.
Essa capacidade de processamento progressivo é essencial para a sensação de velocidade da Web.
É por isso que uma página pode começar a aparecer antes de tudo ter terminado de baixar.
26. O HTML começa a virar DOM
O browser recebe algo parecido com:
Mas internamente ele precisa de uma estrutura com a qual consiga trabalhar.
Então cria o DOM — Document Object Model.
Podemos visualizar:
O DOM é uma representação estruturada do documento que também pode ser manipulada através de JavaScript.
27. Enquanto analisa HTML, o navegador descobre novos recursos
Imagine encontrar:
Agora o navegador percebe:
eu preciso de mais coisas.
Então surgem novas requisições:
É por isso que abrir uma única página pode gerar dezenas ou centenas de requisições de rede.
28. O navegador possui até um scanner de pré-carregamento
Browsers são extremamente otimizados.
Enquanto o parser principal está trabalhando — ou até bloqueado por algum recurso — um analisador secundário pode examinar o HTML adiante tentando descobrir arquivos que serão necessários.
É chamado preload scanner.
Ele pode encontrar antecipadamente:
imagens;
scripts;
stylesheets;
outros recursos presentes no HTML.
e começar downloads antes que o parser principal chegue àquela parte.
Essa é uma das razões pelas quais colocar recursos importantes de forma facilmente descobrível no HTML pode beneficiar performance.
29. O CSS vira CSSOM
HTML cria a estrutura do documento.
CSS determina a apresentação.
Exemplo:
O navegador transforma essas regras em outra estrutura chamada:
CSSOM — CSS Object Model.
Agora temos:
O navegador utiliza essas informações para entender o conteúdo e os estilos aplicáveis.
30. CSS pode bloquear a renderização
O navegador precisa conhecer estilos relevantes antes de desenhar corretamente a página.
Se mostrasse tudo imediatamente apenas com o HTML e aplicasse CSS depois, o usuário poderia ver uma página visualmente quebrada por alguns instantes.
Por isso, CSS necessário para a renderização inicial pode bloquear aquela renderização.
É aqui que começa a importância do Critical Rendering Path, ou caminho crítico de renderização.
31. JavaScript pode bloquear ainda mais trabalho
Considere:
Dependendo de como o script foi declarado, o parser pode precisar parar, baixar o JavaScript e executá-lo antes de continuar.
Isso acontece porque JavaScript pode modificar o próprio documento.
Por exemplo:
Se JavaScript pode alterar a estrutura, o navegador precisa respeitar a ordem correta das operações.
É por isso que atributos como:
podem ser importantes para performance quando utilizados corretamente. A MDN destaca que scripts podem interferir no parsing e que estratégias como async e defer ajudam a evitar bloqueios desnecessários em determinados cenários.
32. DOM + CSSOM ajudam a determinar o que será renderizado
Agora temos:
Elementos que não precisam aparecer visualmente não precisam participar da mesma forma do processo de renderização.
O navegador determina quais nós são visíveis e quais estilos calculados se aplicam a eles.
Depois começa outra etapa.
33. Layout: qual o tamanho e posição de cada elemento?
Saber que existe um título não é suficiente.
O browser precisa descobrir:
qual largura?
qual altura?
qual posição?
qual margem?
qual tamanho de fonte?
onde começa o próximo elemento?
Esse processo é conhecido como layout.
Imagine:
O navegador realiza esses cálculos para os elementos relevantes da página.
34. Paint: finalmente começamos a transformar elementos em pixels
Depois do layout, o navegador sabe:
o que existe;
como parece;
onde fica.
Agora precisa desenhar.
É a fase de paint, ou pintura.
Ela envolve coisas como:
textos;
cores;
bordas;
sombras;
imagens;
fundos.
O navegador transforma a descrição visual em instruções de desenho.
35. Compositing: juntando as camadas
Browsers podem dividir partes da interface em diferentes camadas.
Por exemplo, certos elementos animados ou transformados podem possuir suas próprias camadas.
Depois essas camadas precisam ser combinadas na ordem correta.
Essa etapa é chamada compositing.
Finalmente:
pixels aparecem na tela.
Mas ainda não acabou.
36. A página pode aparecer antes de estar totalmente carregada
Você provavelmente já viu isto:
primeiro aparece texto;
depois fonte;
depois imagem;
depois anúncio;
depois algum widget.
Isso acontece porque páginas web são carregadas e renderizadas progressivamente.
O browser não precisa necessariamente esperar:
para mostrar algo.
Ele tenta apresentar conteúdo assim que possui recursos suficientes para produzir uma experiência utilizável.
Isso é muito importante para performance percebida.
37. JavaScript pode continuar modificando tudo depois
Depois do primeiro paint, JavaScript pode:
buscar dados em APIs;
alterar DOM;
mostrar menus;
carregar comentários;
abrir modais;
adicionar produtos;
atualizar carrinho;
reagir a cliques.
Ou seja:
não significa:
Aplicações modernas podem permanecer ativas durante toda a sessão.
38. React, Vue e Angular entram onde?
Frameworks como React, Vue e Angular operam principalmente na camada de aplicação/frontend.
Eles não substituem:
DNS;
IP;
TLS;
HTTP;
o navegador.
Uma aplicação React ainda precisa chegar ao navegador através da infraestrutura da Web.
Depois disso, JavaScript pode assumir grande parte da criação ou atualização da interface.
Dependendo da arquitetura, o HTML pode ser:
renderizado no servidor;
gerado antecipadamente;
renderizado no cliente;
ou combinar essas estratégias.
Temos uma análise específica sobre React, Vue ou Angular e qual escolher para um novo projeto.
39. E um service worker pode mudar essa história novamente
Progressive Web Apps e outras aplicações podem registrar um service worker.
Ele funciona como uma espécie de proxy programável entre aplicação, navegador e rede.
Pode interceptar requisições.
Por exemplo:
Isso permite experiências offline e estratégias sofisticadas de cache.
Portanto, novamente:
nem toda requisição que uma página faz necessariamente chega à internet.
40. Então quando a página terminou de carregar?
Essa pergunta é mais complicada do que parece.
Podemos ter diferentes momentos:
servidor respondeu;
primeiro byte chegou;
HTML foi recebido;
primeiro conteúdo apareceu;
maior conteúdo apareceu;
evento load ocorreu;
JavaScript terminou uma tarefa;
dados de API chegaram.
Uma aplicação pode continuar fazendo novas requisições indefinidamente.
Por isso, performance web moderna não tenta resumir experiência a uma única métrica.
41. Onde entram as Core Web Vitals?
Todo esse caminho acaba influenciando aquilo que o usuário percebe.
O Google atualmente destaca três métricas principais de Core Web Vitals:
LCP — Largest Contentful Paint
avalia carregamento do principal conteúdo visível.
Boa referência: até 2,5 segundos.
INP — Interaction to Next Paint
avalia capacidade de resposta às interações.
Boa referência: menos de 200 ms.
CLS — Cumulative Layout Shift
avalia estabilidade visual.
Boa referência: menos de 0,1.
Agora fica mais fácil entender por que melhorar velocidade não significa apenas:
“comprimir uma imagem”.
DNS lento pode atrasar.
Servidor lento pode atrasar.
JavaScript pesado pode atrasar.
CSS bloqueante pode atrasar.
Fontes podem atrasar.
Imagens podem causar mudanças de layout.
Tudo faz parte de uma cadeia.
42. Entender esse processo ajuda em SEO?
Sim, principalmente no SEO técnico.
Não porque saber DNS seja um “fator de ranqueamento secreto”.
Mas porque essa compreensão ajuda a diagnosticar problemas que afetam:
rastreamento;
renderização;
performance;
redirecionamentos;
HTTPS;
Core Web Vitals;
experiência do usuário.
O Google recomenda boa experiência de página e bons Core Web Vitals, mas também deixa claro que uma pontuação perfeita não garante primeira posição: relevância e qualidade do conteúdo continuam fundamentais.
43. Onde cada problema normalmente aparece?
Agora podemos transformar teoria em diagnóstico.
“Servidor DNS não encontrado”
Provavelmente existe algum problema antes da conexão HTTP:
DNS;
domínio;
resolvedor;
configuração.
“Sua conexão não é privada”
Pode envolver:
TLS;
certificado;
domínio;
validade;
cadeia de confiança.
404
O servidor foi encontrado.
A comunicação HTTP aconteceu.
Mas aquele recurso não foi localizado.
500
A requisição chegou à infraestrutura, mas algum processamento no servidor falhou.
Página abre, mas está sem estilo
HTML chegou.
CSS pode não ter carregado ou processado corretamente.
Página aparece, mas botão não funciona
HTML e CSS podem estar corretos.
JavaScript pode ter falhado.
Página demora muito antes de mostrar qualquer coisa
Pode envolver:
DNS;
conexão;
TLS;
TTFB;
servidor;
CSS bloqueante;
recursos críticos.
É aqui que entender a cadeia se transforma em uma habilidade prática.
44. Como enxergar tudo isso acontecendo no seu navegador
Você não precisa apenas acreditar que esse processo existe.
Abra as ferramentas de desenvolvedor do navegador.
No Chrome e navegadores derivados:
F12 → Network
Recarregue a página.
Você verá uma lista de requisições.
Normalmente encontrará:
Document;
CSS;
JavaScript;
imagens;
fontes;
fetch/XHR;
outros recursos.
Observe também o Waterfall.
Ele mostra visualmente que recursos começam cedo, quais esperam outros e quanto tempo levam.
Ao abrir uma requisição específica, você consegue investigar:
headers;
status;
tamanho;
cache;
timing;
resposta.
É praticamente um raio-X da viagem que acabamos de explicar.
45. Um exemplo completo: você acessa uma loja virtual
Imagine digitar:
Etapa 1
O browser interpreta a URL.
Etapa 2
Verifica caches e informações já conhecidas.
Etapa 3
Resolve loja.com para um endereço IP quando necessário.
Etapa 4
Estabelece ou reutiliza a conexão.
Etapa 5
Negocia criptografia HTTPS quando necessário.
Etapa 6
Envia algo equivalente a:
Etapa 7
A requisição chega a uma CDN.
Etapa 8
A CDN não possui a página atual em cache.
Etapa 9
Encaminha para a infraestrutura da loja.
Etapa 10
Um load balancer escolhe um servidor.
Etapa 11
A aplicação consulta:
produto;
estoque;
preço;
usuário;
promoções.
Etapa 12
O servidor produz HTML.
Etapa 13
A resposta retorna comprimida.
Etapa 14
Browser começa a interpretar HTML antes mesmo de terminar tudo.
Etapa 15
Descobre CSS, JS, imagens e fontes.
Etapa 16
Novas requisições são realizadas.
Etapa 17
DOM e CSSOM são construídos.
Etapa 18
Estilos são calculados.
Etapa 19
Layout determina posições.
Etapa 20
Paint desenha elementos.
Etapa 21
Compositing junta as camadas.
Etapa 22
Você finalmente enxerga:
Comprar agora.
E provavelmente tudo isso aconteceu rápido o suficiente para parecer apenas um clique.
46. A internet não envia “um site” como um arquivo único
Esse é outro mito comum.
Quando você abre um site, normalmente não recebe:
Você recebe recursos.
Exemplo:
Cada recurso pode:
vir de um domínio diferente;
possuir seu próprio cache;
usar uma CDN diferente;
chegar em momentos diferentes.
A página final é resultado da combinação desses recursos pelo navegador.
47. O servidor também não “manda pixels”
Normalmente ele envia dados.
Pode enviar:
HTML;
JSON;
CSS;
JavaScript;
imagens;
vídeo.
Quem transforma grande parte disso na interface exibida é o navegador.
Por isso Chrome, Firefox, Safari e Edge são softwares extremamente complexos.
Eles não são apenas:
“programas para acessar sites”.
São motores capazes de interpretar linguagens, executar código, administrar rede, segurança, armazenamento, áudio, vídeo, gráficos e muito mais.
48. O que acontece se você acessar o site novamente?
Na segunda visita, a história pode ficar muito menor.
Na primeira:
Em uma visita posterior:
Ou algumas respostas podem ser revalidadas e resultar em 304 Not Modified.
Esse é o motivo pelo qual cache bem planejado tem impacto tão grande na experiência de navegação.
49. HTTP/3 tornou o fluxo moderno ainda mais interessante
Durante muitos anos, a explicação clássica para essa pergunta era:
Continua sendo uma boa base para entender HTTP/1.1 e HTTP/2 sobre HTTPS.
Mas HTTP/3 mudou parte da pilha.
Ele utiliza QUIC sobre UDP, com criptografia integrada ao protocolo de transporte e streams independentes.
Os principais navegadores modernos oferecem suporte a HTTP/3.
Por isso, uma explicação atualizada precisa mostrar:
Sem essa distinção, estamos ensinando apenas a Web de alguns anos atrás.
50. A melhor forma de memorizar todo o processo
Não tente decorar 50 detalhes.
Guarde oito ideias:
1. Interpretar
O browser entende a URL.
2. Localizar
DNS ajuda a encontrar o destino.
3. Conectar
Cliente estabelece ou reutiliza comunicação.
4. Proteger
TLS/QUIC oferecem criptografia em HTTPS moderno.
5. Solicitar
HTTP descreve aquilo que o cliente quer.
6. Processar
Infraestrutura e aplicação produzem uma resposta.
7. Transferir
HTML e outros recursos chegam ao cliente.
8. Renderizar
O navegador transforma dados em pixels.
Em uma linha:
Entendendo isso, os detalhes deixam de parecer peças desconectadas.
Conclusão: pressionar Enter inicia uma das coreografias mais sofisticadas da computação moderna
Quando você digita um endereço no navegador, não está simplesmente:
“abrindo um site”.
Você inicia uma cadeia de sistemas distribuídos.
O navegador interpreta a URL.
Caches tentam eliminar trabalho.
DNS encontra o destino.
Protocolos de transporte estabelecem comunicação.
HTTPS protege a troca de informações.
HTTP transporta requisições e respostas.
CDNs, proxies e servidores podem participar.
Aplicações consultam dados.
HTML começa a chegar.
CSS define aparência.
JavaScript adiciona comportamento.
DOM e CSSOM são processados.
Layout calcula posições.
Paint desenha.
Compositing organiza as camadas.
E então:
pixels aparecem na sua tela.
O mais impressionante é que muitas vezes tudo acontece em menos tempo do que você levou para ler esta frase.
Entender essa sequência muda a forma como você enxerga desenvolvimento web.
DNS deixa de ser um termo isolado.
HTTP deixa de ser apenas algo que aparece antes de uma URL.
HTML deixa de ser simplesmente “o site”.
Backend, frontend, rede e navegador começam a fazer parte de um único sistema.
E é exatamente isso que a Web é:
uma enorme cadeia de tecnologias diferentes trabalhando juntas para fazer um endereço digitado por uma pessoa se transformar em uma experiência visual e interativa.
Perguntas frequentes
O que acontece quando digitamos uma URL no navegador?
O navegador interpreta a URL, consulta caches, resolve o domínio para um endereço IP quando necessário, estabelece ou reutiliza uma conexão, envia uma requisição HTTP, recebe uma resposta e processa HTML, CSS, JavaScript e outros recursos até renderizar a página na tela.
Qual é a primeira coisa que o navegador faz ao acessar um site?
Primeiro ele precisa interpretar aquilo que foi digitado e determinar se é uma URL ou uma pesquisa. Em uma navegação por URL, ele identifica componentes como protocolo, host e caminho e verifica informações que podem ser reutilizadas antes de iniciar novas operações de rede.
O que é DNS e qual sua função?
DNS significa Domain Name System. Ele permite associar nomes de domínio legíveis, como exemplo.com, a endereços IP utilizados para localizar serviços na rede.
O navegador sempre consulta o DNS?
Não. Informações DNS podem estar armazenadas em cache e conexões existentes também podem ser reutilizadas. Portanto, uma resolução DNS completa não ocorre obrigatoriamente em toda navegação.
O que acontece depois da consulta DNS?
Depois de obter um endereço adequado, o navegador precisa estabelecer ou reutilizar comunicação com o destino. Dependendo da versão HTTP, isso pode envolver TCP e TLS ou QUIC sobre UDP no HTTP/3.
O que é o handshake TCP?
É o processo inicial utilizado para estabelecer uma conexão TCP entre cliente e servidor. Ele é tradicionalmente representado pelas mensagens SYN, SYN-ACK e ACK.
O que é TLS?
TLS é o protocolo utilizado para proteger comunicações na Web por meio de criptografia e autenticação. Em conexões HTTPS tradicionais sobre TCP, cliente e servidor realizam uma negociação TLS antes da troca protegida de dados HTTP.
Qual é a diferença entre HTTP e HTTPS?
HTTP define a comunicação de aplicação entre cliente e servidor. HTTPS representa HTTP utilizado com proteção criptográfica, normalmente através de TLS ou através da pilha segura do QUIC em HTTP/3.
O que é HTTP/3?
HTTP/3 é uma versão moderna do HTTP que utiliza QUIC sobre UDP em vez de TCP. Entre seus objetivos estão reduzir latência de conexão e diminuir o impacto de perda de pacotes entre diferentes streams.
O que o servidor envia para o navegador?
Pode enviar HTML, JSON, CSS, JavaScript, imagens, fontes, vídeos e outros recursos. A resposta depende da requisição e da arquitetura da aplicação.
O que significa HTTP 200?
200 OK indica que a requisição foi processada com sucesso. Em uma solicitação GET, normalmente significa que o recurso foi obtido e enviado na resposta.
O que significa erro 404?
404 Not Found indica que o servidor não encontrou o recurso solicitado naquele endereço.
O que significa erro 500?
Um status da família 5xx indica problemas relacionados ao servidor. 500 Internal Server Error é usado quando o servidor encontra uma condição inesperada durante o processamento.
O que é DOM?
DOM, ou Document Object Model, é a representação estruturada do documento HTML utilizada pelo navegador e acessível a JavaScript.
O que é CSSOM?
CSSOM é a representação das regras CSS processadas pelo navegador. Ela participa da determinação dos estilos aplicados aos elementos da página.
Como o navegador transforma HTML em uma página?
O navegador analisa HTML e CSS, cria estruturas internas como DOM e CSSOM, calcula estilos e layout, realiza a pintura dos elementos e compõe as diferentes camadas até produzir os pixels exibidos na tela.
O JavaScript é necessário para carregar todo site?
Não. Sites podem funcionar apenas com HTML e CSS. JavaScript é utilizado quando há necessidade de comportamentos, lógica e interações adicionais.
O que é cache do navegador?
É o armazenamento local de respostas e recursos anteriormente obtidos. Quando permitido pelas regras HTTP, esses dados podem ser reutilizados em acessos posteriores, reduzindo downloads e tempo de carregamento.
O que é uma CDN?
Uma CDN é uma rede distribuída de servidores capaz de entregar conteúdo a partir de pontos mais próximos do usuário e reduzir a necessidade de alcançar diretamente o servidor de origem em todas as requisições.
Por que entender esse processo é importante para desenvolvedores?
Porque ajuda a diagnosticar problemas de DNS, HTTPS, rede, backend, cache, JavaScript, renderização e performance e oferece um modelo mental de como frontend, backend e infraestrutura trabalham juntos.